No universo da Inteligência Artificial, a corrida por modelos cada vez mais potentes e eficientes não para. Novas ferramentas surgem constantemente, prometendo revolucionar a forma como interagimos com a tecnologia. Recentemente, dois nomes têm se destacado nas discussões: o Claude Fable 5, da Anthropic, e o GLM-5, da Z.AI. Mas, na prática, qual deles entrega mais para quem trabalha com digital?
O portal BenchLM.ai, uma autoridade em benchmarks de Large Language Models (LLMs), publicou um comparativo atualizado em 27 de setembro de 2026, colocando esses dois titãs frente a frente. E o resultado? Embora o Claude Fable 5 apareça com uma pontuação geral superior, a história é mais complexa do que um simples número, e as diferenças de custo e aplicabilidade podem mudar tudo para o seu negócio.
Nesta análise aprofundada, vamos mergulhar nos dados do BenchLM.ai para entender o que realmente importa. Veremos quem leva a melhor em termos de performance, quais os custos envolvidos para diferentes cargas de trabalho e o que essas especificações significam para empreendedores digitais, desenvolvedores e profissionais de marketing.
A Batalha dos Gigantes: Quem Lidera no Desempenho Geral?
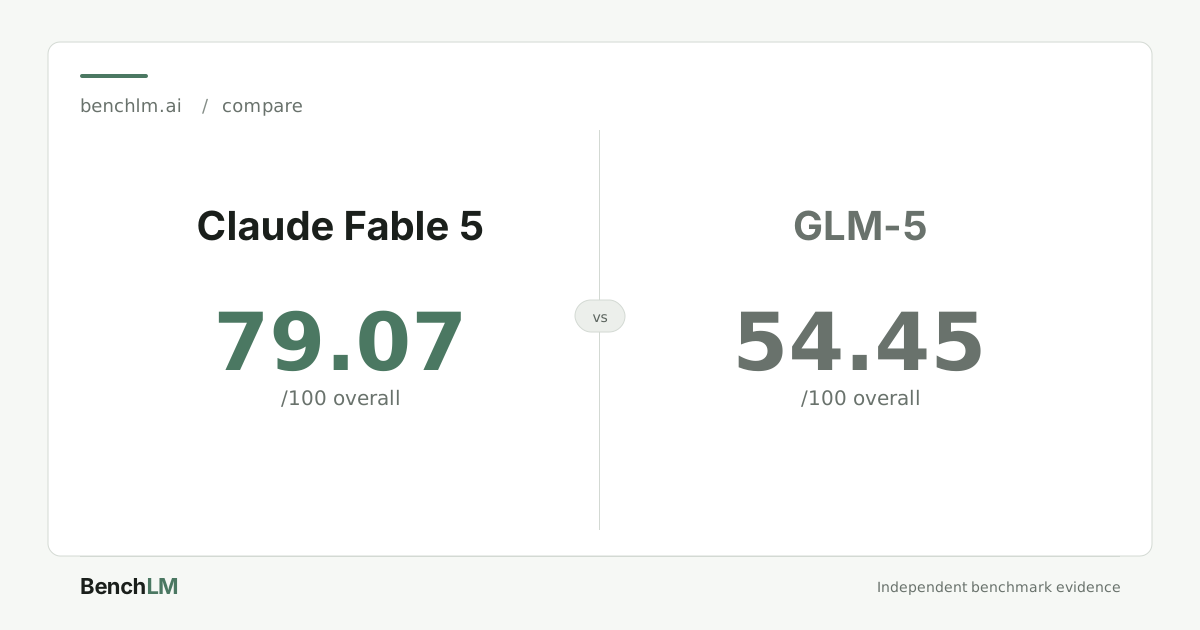
A primeira coisa que salta aos olhos nos dados do BenchLM.ai é a pontuação pública geral: o Claude Fable 5 marcou 79.07 pontos de 100, enquanto o GLM-5 alcançou 54.45. A diferença é significativa, e os intervalos de confiança de 90% (76.0-82.1 para Claude Fable 5 e 44.8-64.2 para GLM-5) não se sobrepõem, o que sugere uma superioridade clara do modelo da Anthropic na performance geral avaliada.
O Claude Fable 5 ocupa a 6ª posição no ranking público geral de modelos, enquanto o GLM-5 está na 61ª. Essa disparidade inicial já nos dá um indício de que o Claude Fable 5, em um panorama amplo, é considerado um modelo mais robusto em diversas tarefas.
No entanto, é crucial notar que essa pontuação é um agregado de diversos benchmarks. Como o próprio BenchLM.ai aponta, "o preço, o acesso e sua carga de trabalho podem derrubar essa vantagem". Para quem está no dia a dia do marketing digital, desenvolvimento ou criação de conteúdo, as necessidades específicas muitas vezes superam a pontuação bruta.
Desempenho em Categorias Específicas: Detalhando os Benchmarks
Quando olhamos para as categorias específicas, a análise fica mais granular. O BenchLM.ai compara os modelos em áreas como Agentic (tarefas de agente, uso de ferramentas), Coding (programação), Knowledge (conhecimento geral), Instruction Following (seguir instruções), Reasoning (raciocínio), Multimodal (múltiplos tipos de dados), Multilingual (múltiplas línguas) e Math (matemática).
É importante ressaltar que muitas dessas comparações são classificadas como "Direcional apenas" ou "Não comparável" pelo BenchLM.ai, principalmente porque um dos modelos pode ter "evidência estimada" ou usar conjuntos de benchmarks diferentes, o que impede uma leitura direta e pareada. No entanto, os números ainda oferecem insights valiosos:
- Agentic (Tarefas de Agente): Claude Fable 5 (73.7, Suportado) vs. GLM-5 (37.2, Estimado). O Claude Fable 5 se mostra muito mais capaz em tarefas complexas que exigem uso de ferramentas e múltiplos passos.
- Coding (Programação): Claude Fable 5 (74.5, Suportado) vs. GLM-5 (39.3, Estimado). Para desenvolvedores e empreendedores que buscam automatizar processos ou gerar código, o Claude Fable 5 parece ter uma vantagem considerável.
- Knowledge (Conhecimento): Claude Fable 5 (81.8, Suportado) vs. GLM-5 (47.1, Estimado). Em termos de acesso e compreensão de vastos volumes de informação, o Claude Fable 5 novamente se destaca.
- Instruction Following (Seguir Instruções): Aqui, surpreendentemente, o GLM-5 (87.2) supera o Claude Fable 5 (75.7), ambos em "Provisional lane". Embora seja uma comparação "Direcional apenas", sugere que o GLM-5 pode ser ligeiramente melhor para tarefas que exigem adesão estrita a instruções complexas.
Em outras categorias como Reasoning, Multimodal, Multilingual e Math, as bases de comparação eram muito distintas ou incompletas, tornando difícil tirar conclusões diretas. Por exemplo, o Claude Fable 5 registra 62.6 em Multimodal (com 2 linhas rankeáveis), enquanto o GLM-5 não é classificado. Já em Multilingual e Math, o GLM-5 aparece com pontuações (48.7 e 56.5, respectivamente) e o Claude Fable 5 não é classificado, indicando focos e evidências diferentes para cada modelo.
Em benchmarks específicos de codificação, como o SWE-bench ProCoding, o Claude Fable 5 alcançou 80% contra 55.1% do GLM-5. No SWE-bench VerifiedCoding, o Claude Fable 5 marcou 95% contra 77.8% do GLM-5. Isso reforça a liderança da Anthropic em tarefas de engenharia de software.
Custo e Eficiência: Onde o GLM-5 Brilha
Se em desempenho geral o Claude Fable 5 tem a dianteira, é nos custos que o GLM-5 se torna um competidor muito atraente. Para empreendedores digitais, freelancers e startups, o custo-benefício é frequentemente um fator decisivo. O BenchLM.ai analisou três cenários de custo baseados em taxas de API padrão:
- Turno de Chat (1K input + 500 output tokens):
- Claude Fable 5: US$ 0.035
- GLM-5: US$ 0.0026
Nesse cenário, o GLM-5 é significativamente mais barato, quase 13 vezes mais acessível por turno de chat. Para aplicações com alta demanda de interações curtas, como chatbots de suporte ou assistentes virtuais, a economia pode ser massiva.
- Revisão de Repositório (50K input + 3K output tokens):
- Claude Fable 5: US$ 0.65
- GLM-5: US$ 0.0596
Novamente, o GLM-5 se destaca, sendo mais de 10 vezes mais barato para tarefas que envolvem processamento de documentos maiores, como revisão de código, análise de contratos ou sumarização de textos extensos.
- Loop de Agente com Cache Pesado (200K cached + 20K fresh input + 10K output tokens):
- Claude Fable 5: US$ 0.9 (cabe em uma única requisição)
- GLM-5: US$ 0.252 (NÃO cabe em uma única requisição e usa a taxa de input para tokens em cache, pois não tem taxa de cache publicada)
Aqui a situação é mais complexa. Embora o custo por token do GLM-5 seja menor, ele não consegue processar essa carga de trabalho em uma única requisição, o que pode adicionar complexidade de desenvolvimento e latência. O Claude Fable 5, com sua janela de contexto maior, lida melhor com esse cenário, mesmo sendo mais caro por token.
Fica claro que para a maioria das cargas de trabalho, o GLM-5 oferece um custo por token consideravelmente menor. Isso o torna uma opção muito atraente para quem precisa de volume e está otimizando o orçamento, desde que a janela de contexto não seja um limitador para a tarefa.
Especificações Técnicas e Diferenças Práticas
Além de performance e custo, as especificações técnicas são fundamentais para decidir qual modelo usar. Aqui estão os pontos chave:
Janela de Contexto (Context Window)
- Claude Fable 5: 1 Milhão de tokens.
- GLM-5: 200 Mil tokens.
A janela de contexto do Claude Fable 5 é absurdamente maior — 5 vezes maior que a do GLM-5. Isso é um divisor de águas para aplicações que lidam com documentos muito longos, como análise de livros inteiros, relatórios financeiros extensos ou bases de conhecimento gigantes. Para quem trabalha com conteúdo que exige memória contextual prolongada (e-books, teses, documentação técnica), o Claude Fable 5 oferece uma capacidade incomparável.
Taxa de Input em Cache (Cached-input rate)
- Claude Fable 5: US$ 1 por 1 Milhão de tokens em cache.
- GLM-5: Taxa não publicada.
A Anthropic especifica uma taxa de cache, o que é ótimo para otimizar custos em fluxos de trabalho onde parte da informação é recorrente. O GLM-5, por não ter uma taxa de cache publicada, acaba precificando tokens em cache como tokens de input normais em algumas estimativas, o que pode aumentar o custo em cenários específicos, como o "Cache-heavy agent loop" que vimos antes.
Inputs e Outputs Documentados
- Claude Fable 5: Aceita texto e imagem como input, e gera texto como output.
- GLM-5: Não há dados documentados na fonte sobre inputs e outputs.
A capacidade multimodal do Claude Fable 5 de processar imagens é uma vantagem enorme para quem trabalha com análise de mídias visuais, criação de descrições para e-commerce baseadas em fotos de produtos, ou ferramentas de acessibilidade. A falta dessa documentação para o GLM-5 pode ser um limitador para certas aplicações.
Disponibilidade do Provedor e Licença
- Claude Fable 5: Disponibilidade Geral via Claude API. Licença proprietária.
- GLM-5: Não documentado na fonte, mas a Z.AI indica "Open Weight" e licença "Open Weight".
A natureza "Open Weight" do GLM-5 é um ponto crucial. Significa que os pesos do modelo podem ser acessados e, potencialmente, o modelo pode ser executado localmente ou em infraestrutura própria. Isso oferece mais controle, privacidade e, em alguns casos, pode reduzir custos a longo prazo para empresas que têm capacidade computacional interna. Já o Claude Fable 5, sendo proprietário, é acessível apenas via API da Anthropic.
Perfil de Raciocínio (Reasoning Profile)
- Claude Fable 5: "Reasoning" (Raciocínio).
- GLM-5: "Non-Reasoning" (Não-Raciocínio).
Essa é uma distinção importante. Modelos com perfil "Reasoning" são projetados para lidar melhor com tarefas que exigem lógica, inferência e compreensão profunda. Para aplicações que envolvem tomada de decisão complexa, análise estratégica ou resolução de problemas, o Claude Fable 5 tem uma vantagem arquitetônica. O "Non-Reasoning" do GLM-5 sugere que ele pode ser mais focado em tarefas de geração e compreensão mais diretas, onde o custo-benefício é o principal driver.
Impacto para quem Trabalha com Digital: Escolhendo sua IA
Com todas essas informações, como um empreendedor digital ou profissional de tecnologia deve escolher entre Claude Fable 5 e GLM-5?
- Para Desenvolvedores e Engenheiros de Software: Se sua prioridade é a performance em codificação, agentic tasks e a capacidade de processar documentos extensos (como repositórios de código gigantes ou documentação técnica), o Claude Fable 5 é o caminho. Sua janela de contexto de 1 Milhão de tokens e o desempenho superior em benchmarks de código são imbatíveis. No entanto, esteja preparado para um custo maior.
- Para Marketing de Conteúdo e Criação: Se você precisa gerar muito conteúdo, resumir textos, responder a prompts de chat de forma consistente e com baixo custo, o GLM-5 é uma excelente opção. Para criação de copy, e-mails marketing, descrições de produtos ou mesmo roteiros, onde o volume é grande e as instruções são claras, o GLM-5 oferece um custo-benefício imbatível. Sua capacidade de "Instruction Following" ligeiramente superior também pode ser um diferencial.
- Para Automação de Processos e Chatbots: Para construir chatbots de atendimento ao cliente, assistentes virtuais ou automatizar fluxos de trabalho baseados em texto, o GLM-5 novamente se destaca pelo custo. A economia em milhares de interações pode ser enorme. No entanto, para agentes mais complexos que precisam de uma "memória" de conversação muito longa ou integração multimodal (análise de imagens), o Claude Fable 5 pode justificar o investimento extra.
- Para Análise de Dados e Pesquisa: A janela de contexto gigantesca do Claude Fable 5 o torna ideal para analisar grandes volumes de dados textuais, realizar pesquisas aprofundadas em documentos extensos ou construir sistemas de RAG (Retrieval Augmented Generation) com vastas bases de conhecimento.
É importante lembrar que esses modelos estão em constante evolução. O BenchLM.ai atualizou esses dados em setembro de 2026, e "ambos os modelos mudarão", como eles próprios afirmam. Por isso, a recomendação é sempre testar os modelos com suas próprias cargas de trabalho representativas antes de migrar ou implementar em produção.
Se você já usa um desses modelos, o BenchLM.ai sugere que observe as diferenças de custo (Repository review: US$0.65 vs US$0.0596; Cache-heavy agent loop: US$0.9 vs US$0.252, com a ressalva do GLM-5 não encaixar em uma única requisição), a qualidade dos sinais (Claude Fable 5 tem a pontuação geral superior) e o trade-off de contexto (Claude Fable 5 com 1M vs GLM-5 com 200K).
Conclusão: Não Existe um Vencedor Único
No final das contas, não há um "melhor" modelo absoluto entre Claude Fable 5 e GLM-5. A escolha ideal dependerá das suas necessidades específicas, do seu orçamento e do tipo de tarefa que você precisa realizar. O Claude Fable 5 é o campeão em performance bruta e capacidade de contexto, ideal para as tarefas mais exigentes e complexas que envolvem grandes volumes de dados e raciocínio avançado.
Já o GLM-5 se destaca como o rei da eficiência e do custo-benefício, sendo a escolha perfeita para aplicações em larga escala que exigem alta performance a um preço acessível, especialmente para tarefas mais diretas de geração de texto e seguimento de instruções, onde a janela de contexto não é um gargalo.
A era da IA nos mostra que a diversidade de modelos é uma riqueza. Saber escolher a ferramenta certa para cada desafio é o que diferencia o empreendedor digital de sucesso. Mantenha-se atualizado, teste as ferramentas e adapte-se constantemente para tirar o máximo proveito dessa revolução tecnológica.
Com informações de benchlm.ai.